Unternehmens- und Roboterdatenbank
NVIDIA CUDA erklärt: Die Software hinter NVIDIAs KI-Burggraben
Die wichtigsten Punkte
- CUDA (2006) ist die Softwareplattform, kein Chip — sie ermöglicht es Entwicklern, universellen Code zu schreiben, der direkt auf NVIDIA-GPUs läuft.
- Ein sechsjähriger Vorsprung vor Beginn der GPU-Ära der KI wuchs sich zu einem Software-Burggraben aus, den konkurrierende Chiphersteller bis heute nicht überwunden haben.
- NVIDIA zufolge stützt CUDA inzwischen weltweit 6 Millionen Entwickler, auch wenn Konkurrenten wie OpenAIs Triton an der CUDA-spezifischen Bindung nagen.
01CUDA im Überblick
CPU vs. GPU: wenige große Kerne gegen Tausende kleiner
Der zentrale Vorteil einer GPU gegenüber einer CPU liegt darin, dass sie Tausende kleiner Recheneinheiten besitzt, die dieselbe Operation gleichzeitig auf vielen Datenpaketen ausführen können, statt wenige Kerne zu nutzen, die auf schnell wechselnde, unterschiedliche Operationen nacheinander optimiert sind. Für Grafik ist das ideal — jedes Pixel auf dem Bildschirm braucht ähnliche Berechnungen —, aber vor CUDA musste man dieselbe Parallelität für alles andere als Grafikoperation tarnen und über OpenGL durchschleusen: ein umständlicher, begrenzter Behelf.
CPU (Hauptprozessor)
Wenige große, universelle Kerne, jeweils darauf optimiert, möglichst schnell viele unterschiedliche Operationen nacheinander auszuführen.
GPU (Grafikprozessor)
Tausende kleine, jeweils einfache Kerne, die alle gleichzeitig dieselbe Operation auf unterschiedlichen Datenteilen ausführen können.
Die Proportionen sind illustrativ und entsprechen nicht der tatsächlichen Kernzahl eines bestimmten Chips.
CUDAs Start 2006
CUDA, im November 2006 gestartet, ist eine Plattform — eine Sammlung von Erweiterungen für C und C++ (später auch Python, Fortran und weitere Sprachen), ein Compiler und eine Laufzeitumgebung —, mit der Entwickler Code schreiben können, der direkt auf den parallelen Kernen einer GPU läuft, organisiert als Raster aus Tausenden gleichzeitiger „Threads“, ohne ihn als Grafikaufgabe zu tarnen. Genau diese Änderung erlaubte es Forschern außerhalb der Computergrafik, GPUs erstmals für Physiksimulationen, Proteinfaltung und schließlich neuronale Netze einzusetzen.
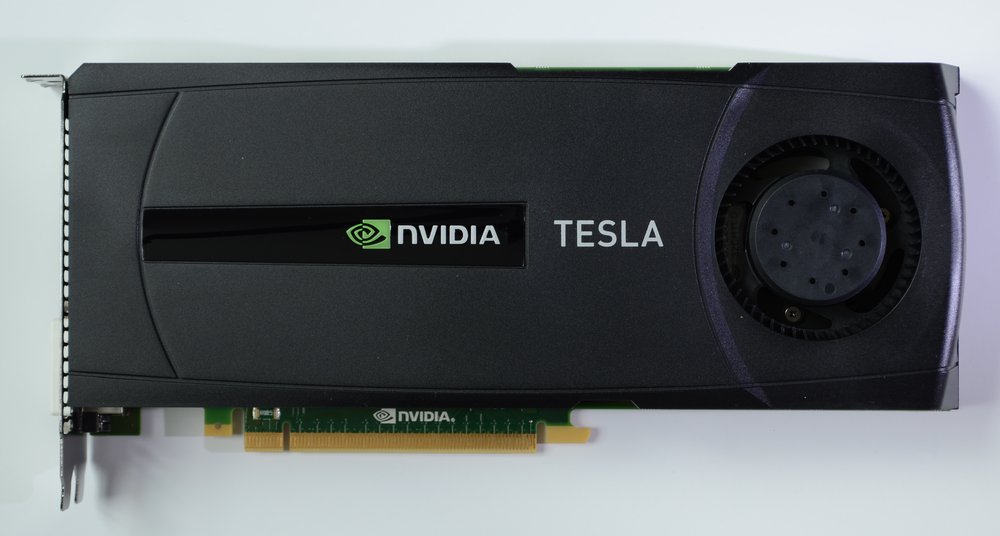
Eine Compute-GPU von NVIDIA unter der Marke Tesla — die Produktlinie, die NVIDIA gezielt für CUDA-Workloads verkaufte (Wissenschaft, Simulation und später Deep Learning) statt für Gaming, Jahre bevor „KI-Chip“ überhaupt als Kategorie galt.
Foto: Raysonho, CC0, via Wikimedia Commons02Vom Compiler zum Bibliotheks-Imperium
CUDA selbst ist nur die Basisschicht. Was in der Praxis tatsächlich verwendet wird, ist ein Stapel spezialisierter Bibliotheken, die NVIDIA über zwei Jahrzehnte darauf aufgebaut hat, jede für eine bestimmte Problemklasse optimiert.
Der Bibliotheken-Stack von CUDA
- cuBLAS und cuFFT — lineare Algebra und Signalverarbeitung, aus CUDAs frühesten Jahren
- cuDNN (2014) — Deep-Learning-Grundfunktionen (Faltungen, Aktivierungsfunktionen), die später den KI-Boom antrieben
- NCCL — koordiniert die Kommunikation zwischen Tausenden GPUs in einem einzigen Trainingslauf
- TensorRT — optimiert ein trainiertes Modell für möglichst schnelle Inferenz
- RAPIDS — bringt CUDA-beschleunigtes Rechnen in Data-Science-Workloads, die früher einen CPU-Cluster benötigten
Jede dieser Bibliotheken steht für Jahre an Feinabstimmung durch NVIDIA-Ingenieure speziell für NVIDIAs eigene Hardware — Optimierungsarbeit, die ein Konkurrent für seine eigenen Chips von Grund auf wiederholen muss.
| Jahr | Ereignis |
|---|---|
| 2006-11 | CUDA 1.0 erscheint zusammen mit der Tesla-GPU-Architektur |
| 2007 | cuBLAS und cuFFT erscheinen — die ersten breit genutzten CUDA-Mathematikbibliotheken |
| 2012 | AlexNet, trainiert auf CUDA-programmierten GPUs, gewinnt ImageNet und verändert das maschinelle Lernen grundlegend |
| 2014 | cuDNN erscheint mit handoptimierten Grundfunktionen speziell für Deep Learning |
| 2015 | NCCL erscheint und koordiniert die Kommunikation zwischen vielen GPUs in einem einzigen Trainingslauf |
| 2016 | TensorRT erscheint und optimiert trainierte Modelle für schnelle Inferenz |
| 2018 | RAPIDS erscheint und bringt CUDA-beschleunigtes Rechnen in Data-Science-Workloads |
| 2026-01 | NVIDIA baut ein Triton-zu-Tile-IR-Backend, mit dem OpenAIs Triton direkt in CUDA Tile IR kompilieren kann |
| 2026-04 | NVIDIA begeht CUDAs 20. Jahrestag auf der GTC und nennt 6 Millionen Entwickler |
03Die Größenordnung des Ökosystems heute
CUDA in Zahlen
NVIDIA beging den 20. Jahrestag von CUDA im April 2026 auf der GTC und gab an, die Plattform stütze inzwischen 6 Millionen Entwickler weltweit — eine selbst berichtete Zahl, nicht unabhängig geprüft, aber konsistent mit CUDAs breit bestätigtem Ruf als die Plattform, die die meisten Forscher zuerst lernen.
Das Schwungrad und ein Abwärtskompatibilitätsversprechen
CEO Jensen Huang beschrieb CUDAs Wirtschaftlichkeit als „Schwungrad“: Zwei Jahrzehnte kumulierter CUDA-kompatibler GPU-Installationen schaffen die installierte Basis, die Entwickler und neue Anwendungen anzieht, was wiederum den Kauf noch mehr CUDA-kompatibler Hardware rechtfertigt. NVIDIA gibt zudem an, dass für die ursprünglichen GPUs von 2006 geschriebener CUDA-Code unverändert auf aktueller Hardware läuft — ein konkretes Abwärtskompatibilitätsversprechen und einer der Gründe, warum eine auf CUDA aufgebaute Codebasis mit fortschreitender NVIDIA-Hardware selten neu geschrieben werden muss.
NVIDIAs eigener Rückblick auf 20 Jahre CUDA (April 2026), veröffentlicht auf der GTC zusammen mit den im Abschnitt weiter unten eingeordneten Angaben zu „6 Millionen Entwicklern“ und dem „CUDA-Schwungrad“.
04Der Burggraben: warum ein Wechsel schwerfällt
Jahre kleiner, hardwarespezifischer Entscheidungen
Keine der einzelnen NVIDIA-Bibliotheken ist grundsätzlich unmöglich nachzubauen — Konkurrenten haben vergleichbare entwickelt. Schwer zu kopieren ist die Anhäufung: Produktive KI-Systeme auf CUDA-Basis enthalten typischerweise Jahre kleiner, hardwarespezifischer Entscheidungen — Kernel-Optimierungen, die auf NVIDIAs konkrete Speicherhierarchie zugeschnitten sind, Mixed-Precision-Trainingspfade rund um NCCLs Annahmen, Debugging- und Profiling-Workflows um NVIDIAs eigene Werkzeuge (Nsight) sowie CI/CD-Pipelines, die CUDA als gegeben voraussetzen. Nichts davon steht im Datenblatt eines Chips, und all das muss mit realem Ingenieuraufwand neu gebaut werden, um auf eine andere Plattform zu wechseln.
PyTorch und TensorFlow wurden CUDA-first entwickelt
Auch die beiden meistgenutzten Deep-Learning-Frameworks, PyTorch und TensorFlow, wurden CUDA-first entwickelt; beide unterstützen inzwischen weitere Backends, doch CUDA bleibt bei beiden der am besten unterstützte und dokumentierte Weg.
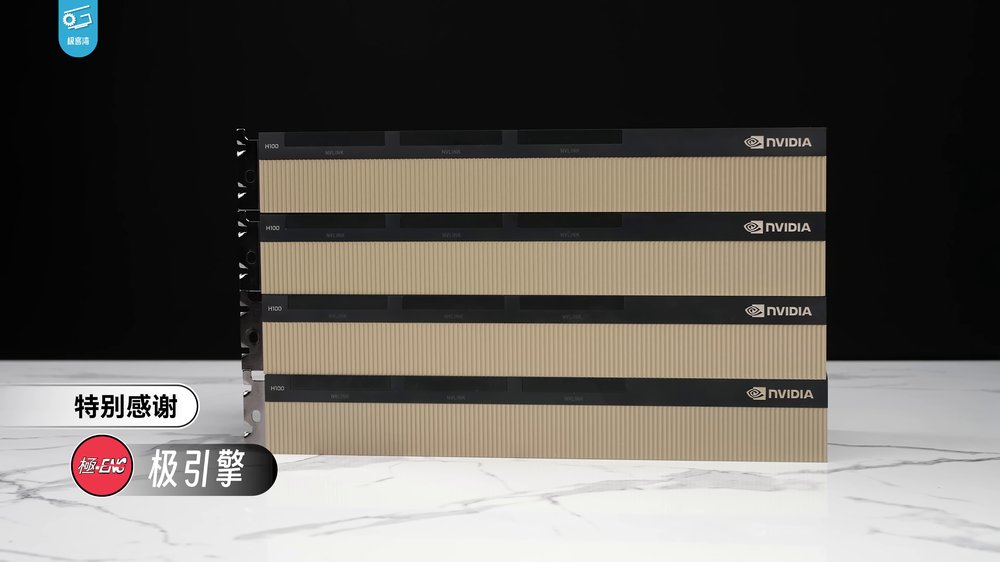
Der H100 (2022) — NVIDIA selbst betont, dass 2006 geschriebener CUDA-Code auch auf aktueller Hardware wie dieser noch läuft, nur deutlich schneller — ein Abwärtskompatibilitätsversprechen, das im Abschnitt weiter unten eingeordnet wird.
Foto: Geekerwan, CC BY 3.0, via Wikimedia Commons05Risse im Burggraben
Triton: eine portable Kernel-Sprache
Die klarste Herausforderung für die CUDA-Bindung ist kein Konkurrenzchip — es ist eine konkurrierende Abstraktionsschicht. OpenAIs Triton, eine Python-basierte Sprache zum Schreiben von GPU-Kerneln, lässt Entwickler Code einmal schreiben und auf unterschiedlicher Hardware nahezu konkurrenzfähige Leistung erzielen, und ist inzwischen der Standardweg zur Kernel-Erzeugung im eigenen Compiler von PyTorch (torch.compile) — ein wachsender Anteil neuen PyTorch-Codes berührt CUDA-spezifischen Code also gar nicht mehr direkt.
NVIDIAs Antwort und eine umstrittene Lesart der Strategie
NVIDIAs eigene Antwort, auf der GTC 2026 vorgestellt, ist CUDA Tile IR samt eines Backends, das Triton direkt dorthin kompilieren lässt — NVIDIA bezeichnet das als Zusammenarbeit, da Tritons eigenes kachelbasiertes Programmiermodell natürlich auf Tile IR abbildet und Entwicklern NVIDIA-spezifische Beschleunigungen erlaubt, ohne Triton zu verlassen. Einige der ursprünglichen CUDA-Ingenieure haben öffentlich widersprochen und argumentiert, NVIDIAs verwandte Sprache cuTile ziele stärker darauf ab, Entwickler von Triton wegzuziehen, als NVIDIAs öffentliche Darstellung nahelegt — eine tatsächlich umstrittene Lesart von NVIDIAs eigener Strategie, keine ausgemachte Sache.
Die Alternativen, Stand 2026
CUDA (NVIDIA)
20 Jahre angesammelter Bibliotheken, Werkzeuge und Dokumentation. Die Standardplattform, die die meisten KI-Forscher zuerst lernen, und das am besten unterstützte Backend in PyTorch und TensorFlow.
ROCm (AMD)
PyTorch, vLLM und SGLang unterstützen ROCm Stand 2026 alle offiziell, und AMD berichtet große Inferenzfortschritte von Generation zu Generation — echter Fortschritt bei gut unterstützten Workloads, auch wenn das breitere Bibliotheken-Ökosystem CUDA weiterhin hinterherhinkt.
Triton (OpenAI)
Eine portable, Python-basierte Kernel-Sprache statt einer Chipplattform — inzwischen der Standardweg zur Kernel-Erzeugung im eigenen Compiler von PyTorch und wohl die bislang direkteste Aufweichung der CUDA-spezifischen Bindung.
oneAPI (Intel)
Intels architekturübergreifende Softwareplattform für CPUs, GPUs und andere Beschleuniger — positioniert als offene Alternative, wenn auch mit kleinerer installierter Basis und schwächerem Bibliotheken-Ökosystem als CUDA oder ROCm.
06Warum CUDA zählt
CUDA selbst ist kein Produkt, das NVIDIA verkauft oder gesondert ausweist — es ist kostenlos nutzbar, und seine Rendite zeigt sich vollständig in NVIDIAs Hardwareverkäufen, die der Markt entsprechend bewertet. NVIDIAs gesamte Marktkapitalisierungsentwicklung und Rechenzentrumsumsätze werden ausführlich im GPU-Geschichtsartikel dieser Seite behandelt; der CUDA-spezifische Punkt ist, dass nicht die Rohdaten eines einzelnen Chips, sondern die Tiefe des Ökosystems der am schwersten zu erreichende Teil von NVIDIAs Position ist.
Weiterführende Beiträge
NVIDIA: eine Geschichte der GPU
NVIDIAs eigene Entwicklung von Marktkapitalisierung und Rechenzentrumsumsatz im vollen Überblick.
07Kommende Herausforderungen
Marktanteilsschätzungen schwanken je nach Quelle
Marktanteilszahlen zu CUDAs Dominanz schwanken je nach Quelle stark und sind nicht unabhängig geprüft — je nach Methodik und Zeitraum reichen verschiedene Analystenschätzungen zu NVIDIAs Anteil bei KI-Beschleunigern von rund 75 % bis in die hohen 80er-Prozentbereiche, und keine veröffentlicht eine vollständig transparente, nachprüfbare Methodik. Jede Einzelzahl sollte nur als Richtwert gelten.
AMDs ROCm holt auf
AMDs ROCm-Plattform hat real aufgeholt: Stand 2026 unterstützen PyTorch, vLLM und SGLang alle offiziell ROCm, und AMD berichtet deutliche Inferenzleistungssprünge von Generation zu Generation — für bestimmte, gut unterstützte Workloads hat sich der praktische Leistungsabstand zu CUDA also verringert, auch wenn das breitere Ökosystem (Dokumentation, Reife der Werkzeuge, Abdeckung von Randfällen in Bibliotheken) weiterhin zurückliegt.
Ob Triton den Burggraben untergräbt, bleibt offen
Ob portable Compiler wie Triton NVIDIAs CUDA-Burggraben letztlich untergraben oder von ihm absorbiert werden, ist nach wie vor offen — die Gründe dafür stehen im Abschnitt „Risse im Burggraben“ weiter oben.
Weiterführende Beiträge
NVIDIA Jetson (Edge-Hardware)
Die Edge-AI-Hardwarelinie, die dem Physical-AI-Boom um mehr als ein Jahrzehnt vorausging.
08Häufige Fragen
Ist CUDA ein Chip oder Software?
Software. CUDA ist eine Plattform für paralleles Rechnen — Spracherweiterungen, ein Compiler und eine Laufzeitumgebung —, mit der Entwickler Code schreiben, der direkt auf NVIDIA-GPU-Hardware läuft. Sie ist kostenlos nutzbar; NVIDIAs Rendite daraus kommt ausschließlich über den Verkauf von GPU-Hardware.
Warum können Konkurrenten CUDA nicht einfach kopieren?
Die einzelnen Bausteine (Compiler, Bibliotheken) lassen sich annähern und wurden von Konkurrenten wie AMDs ROCm bereits angenähert. Schwer zu kopieren sind 20 Jahre angesammelter Produktivcode, der auf CUDA-spezifischen Annahmen aufbaut — Kernel-Optimierungen, Debugging-Werkzeuge und Framework-Unterstützung —, die für einen Plattformwechsel alle neu entwickelt werden müssten, mit echten Kosten und Risiken.
Bedroht OpenAIs Triton CUDA?
Das ist bislang die direkteste Erosion der CUDA-spezifischen Bindung: Mit Triton lassen sich portable GPU-Kernel schreiben, und es ist inzwischen der Standardweg zur Kernel-Erzeugung in PyTorchs Compiler. Ob NVIDIAs eigenes Triton-zu-Tile-IR-Backend diese Bedrohung entschärft oder auf eine echte reagiert, ist tatsächlich umstritten — mehr dazu im Abschnitt „Risse im Burggraben“ weiter oben.
09Quellen
03. Die Größenordnung des Ökosystems heute
05. Risse im Burggraben
Verwandte Artikel
Artikel
Unternehmens- und Marktdaten
Unternehmensanalysen
Unternehmen Tesla
Unitree
Figure AI
1X Technologies
Physical Intelligence
Skild AI
NVIDIA – Unternehmen
- ›NVIDIA Isaac GR00T erklärt: Was NVIDIA in der Robotik wirklich verkauft
- ›NVIDIA DRIVE erklärt: die Automobil-Plattform hinter Mercedes-Benz, Uber und einem Dutzend weiterer Autohersteller
- ›NVIDIA Jetson: Die jahrzehntealte Hardware-Linie hinter Physical AI
- ›NVIDIA: eine Geschichte der GPU
- ›NVIDIA CUDA erklärt: Die Software hinter NVIDIAs KI-Burggraben(dieser Artikel)
- ›Jensen Huang: Vom Tellerwäscher bei Denny's zum NVIDIA-CEO