企業・製品DB
NVIDIA CUDAとは:NVIDIAのAI覇権を支えるソフトウェアの正体
NVIDIAのシリコンを、開発者が実際にプログラムできるものへと変えるソフトウェア基盤です。
カタログスペックで勝る競合チップが、実際の現場ではNVIDIAに負けてしまう理由でもあります。
要点
- CUDA(2006年発売)はチップではなくソフトウェア基盤で、開発者がNVIDIA製GPU上で直接動く汎用コードを書けるようにする。
- AIのGPU活用が本格化する前の6年間の先行投資が、競合が今も追いつけないソフトウェアの参入障壁になった。
- NVIDIAは現在CUDAが世界600万人の開発者を支えていると発表しているが、OpenAIの「Triton」などがCUDA固有のロックインを切り崩しつつある。
01CUDAとは
CPUとGPU:少数の大きなコア vs. 数千個の小さなコア
GPUがCPUに勝る最大の強みは、小さな処理コアを何千個も搭載し、同じ処理を大量のデータへ一斉に適用できる点です。CPUは逆に、異なる処理を次々とこなす少数の高性能コアに最適化されています。画面上の無数のピクセルへ似たような計算を繰り返すグラフィックス処理には、GPUのこの仕組みがまさに理想的でした。ただしCUDA以前は、この並列性をグラフィックス以外の用途で使おうとすると、計算をグラフィックス処理に見せかけてOpenGL経由で流し込むしかなく、扱いにくく制約の多い回避策に頼らざるを得ませんでした。
CPU
少数の大きな汎用コアで、それぞれが多種多様な処理をできるだけ高速に、一つずつ順番にこなせるよう作られています。
GPU
数千個の小さなコアで、一つひとつは単純ですが、同じ処理を異なるデータに対して一斉に実行できます。
あくまで概念を示す比率で、特定のチップの実際のコア数ではありません。
2006年に登場したCUDA
2006年11月に登場したCUDAは、C・C++(後にPython・Fortranなどにも対応)向けの拡張機能とコンパイラ、ランタイムから成るプラットフォームです。開発者はこれによって、グラフィックス処理を装う必要なく、GPUの並列コア上で直接動くコードを書けるようになりました。書いたコードは、何千もの並行「スレッド」の集合体として組み立てられます。この変化がきっかけとなり、コンピュータグラフィックスとは無縁だった研究者たちが、物理シミュレーションやタンパク質の折り畳み構造解析、さらにはニューラルネットワークにまでGPUを向け始めました。
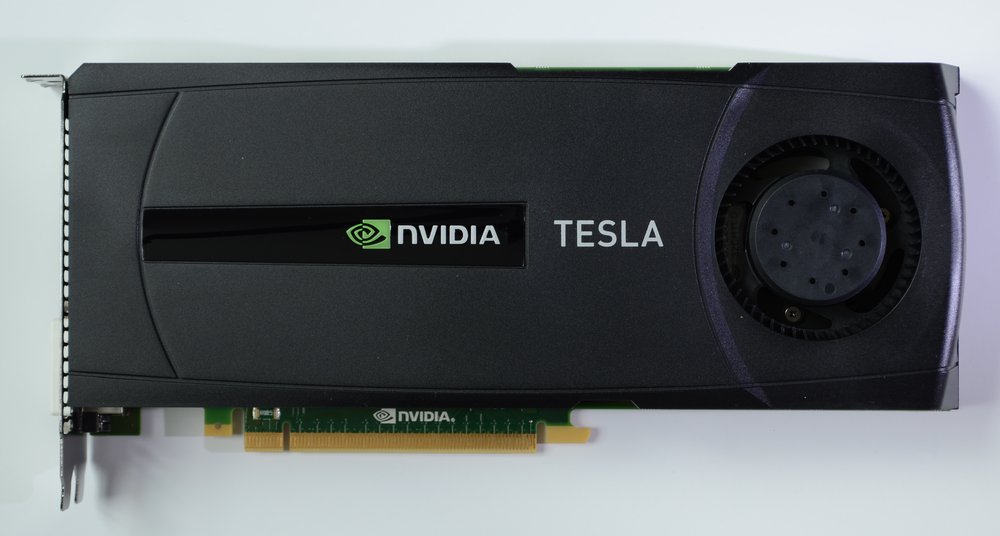
NVIDIA「Tesla」ブランドの演算用GPU。ゲーミング向けではなく、CUDA向けの用途(科学技術計算・シミュレーション、後に深層学習)に特化して販売していた製品ラインです。「AIチップ」という括りが語られるようになるずっと前のことです。
写真: Raysonho、CC0、Wikimedia Commons経由02コンパイラからライブラリ群へ
CUDA自体は基盤となる一つの層にすぎません。実際に本番環境で使われているのは、その上にNVIDIAが20年かけて積み上げてきた、用途ごとに最適化されたライブラリ群です。
CUDA上のライブラリ群
- cuBLASとcuFFT:CUDA黎明期からの線形代数・信号処理向けライブラリ
- cuDNN(2014年):後にAIブームを支えることになる深層学習特有の演算(畳み込み・活性化関数など)向け
- NCCL:数千基のGPUにまたがる学習ジョブの通信を調整
- TensorRT:学習済みモデルの推論をできる限り高速化
- RAPIDS:かつてはCPUクラスタが必要だったデータサイエンス処理にCUDAの高速化を拡張
これらのライブラリはいずれも、NVIDIAのエンジニアが自社ハードウェア向けに何年もかけて手作業でチューニングを重ねた成果です。競合他社は、この最適化作業を自社チップ向けにゼロからやり直さなければなりません。
| 年 | 出来事 |
|---|---|
| 2006-11 | GPUアーキテクチャ「Tesla」と同時に「CUDA 1.0」を発売 |
| 2007 | cuBLASとcuFFTを公開。広く使われた最初のCUDA数学ライブラリ |
| 2012 | CUDAでプログラムされたGPUで学習した「AlexNet」がImageNetで優勝、機械学習の潮流を変える |
| 2014 | 深層学習向けに手動チューニングされたプリミティブを提供する「cuDNN」を発売 |
| 2015 | 1回の学習ジョブで多数のGPU間の通信を調整する「NCCL」を公開 |
| 2016 | 学習済みモデルの高速推論向けに最適化する「TensorRT」を発売 |
| 2018 | CUDAによる高速化をデータサイエンス処理にも広げる「RAPIDS」を発売 |
| 2026-01 | NVIDIAがTriton→Tile IRのバックエンドを構築、OpenAIの「Triton」がCUDA Tile IRへ直接コンパイル可能に |
| 2026-04 | GTCでCUDA発表20周年を発表、開発者数「600万人」を掲げる |
03現在のエコシステムの規模
CUDA、数字で見る
NVIDIAは2026年4月のGTCでCUDA発表20周年を祝い、世界600万人の開発者がこのプラットフォームを支えにしていると発表しました。これはNVIDIA自身の申告による数値で、独立した監査は受けていません。とはいえ、研究者が最初に学ぶ定番のプラットフォームとしてCUDAが広く報じられてきた実態とは矛盾しません。
フライホイールと後方互換性の約束
CEOのジェンスン・フアン氏は、CUDAが生む経済圏を「フライホイール」と表現しています。20年にわたって積み重なったCUDA対応GPUの導入実績が、開発者や新しいアプリケーションを引き寄せる土台となり、それが今度はCUDA対応ハードウェアの追加購入を後押しする、という好循環です。NVIDIAはさらに、2006年当時の初期GPU向けに書いたCUDAコードが、手を加えないまま現行世代のハードウェアでも動くと説明しています。これは具体的な後方互換性の主張です。CUDAを土台にしたコードベースが、NVIDIAのハードウェアが世代を重ねてもほとんど書き直しを必要としない理由の一つでもあります。
CUDA発表から20年を振り返るNVIDIA公式の記念映像(2026年4月)。GTCで公開され、下記の節で扱う「600万人の開発者」や「CUDAフライホイール」という表現とともに発表されました。
04CUDAの「モート」:乗り換えが難しい理由
積み重なった、ハードウェア固有の細かな判断
NVIDIAの個々のライブラリは、原理的には再現不可能というわけではありません。実際、競合他社も同等のものを作り上げてきました。本当に難しいのは、その積み重ねです。CUDAを土台に動いている本番のAIシステムには、たいてい何年分もの細かなハードウェア固有の判断が染み込んでいます。具体例を挙げると、NVIDIA特有のメモリ階層に合わせたカーネル最適化、NCCLの前提を軸に組んだ混合精度学習の経路、NVIDIA純正ツール「Nsight」を前提にしたデバッグ・プロファイリング作業、そしてCUDAの存在を当然の前提とするCI/CDパイプラインなどです。こうした要素はチップの仕様書にはいっさい現れません。それでも別のプラットフォームへ移るとなれば、これら全部を、実際のエンジニアリングコストをかけて作り直す羽目になります。
PyTorchとTensorFlowはCUDA前提で生まれた
深層学習フレームワークとして最も広く使われているPyTorchとTensorFlowも、どちらもCUDAを前提に生まれました。その後は他のバックエンドへの対応も加わりましたが、両フレームワークの中でいまも最もサポートが手厚く、ドキュメントが整っているのはCUDA経由です。
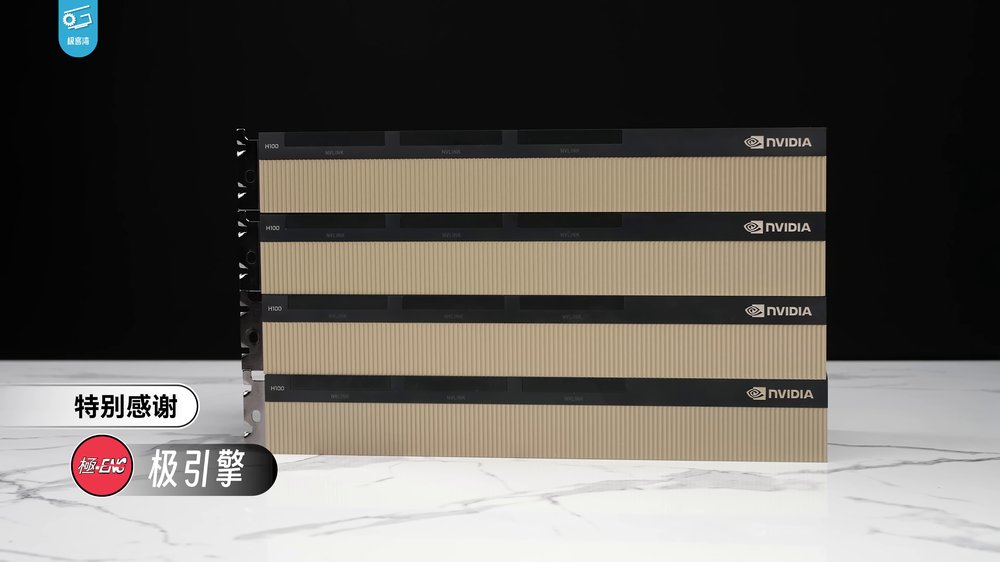
「H100」(2022年)。NVIDIA自身の説明によれば、2006年に書かれたCUDAコードは、こうした現行世代のハードウェア上でも、はるかに高速化された形で今も動作するとされています。この後方互換性の主張については下記の節で扱います。
写真: Geekerwan、CC BY 3.0、Wikimedia Commons経由05モートに入った亀裂
Triton:可搬性の高いカーネル言語
CUDAロックインへの最も明確な挑戦者は、競合チップではなく、競合する抽象化レイヤーです。OpenAIの「Triton」は、GPUカーネルを書くためのPythonベースの言語で、一度書いたコードを異なるハードウェア間でもそこそこの性能で動かせます。今ではPyTorch自身のコンパイラ「torch.compile」における既定のカーネル生成経路にもなっており、新しく書かれるPyTorchコードの多くは、もはやCUDA特有のコードに直接触れることすらなくなりつつあります。
NVIDIAの応答と、戦略をめぐる意見の対立
これに対するNVIDIA自身の答えが、GTC 2026で予告された「CUDA Tile IR」です。Tritonがこれをバックエンドとして、Tile IRへ直接コンパイルできる仕組みも合わせて用意されました。NVIDIAはこれを協調的な取り組みだと位置づけています。Tritonがもともと採用しているタイルベースのプログラミングモデルが、Tile IRと自然に対応するため、開発者はTritonから離れずにNVIDIA固有の高速化を得られるという理屈です。ただし、CUDAを生み出した当初のエンジニアチームの一部は、この説明に公然と異議を唱えています。関連する「cuTile」言語は、NVIDIAの公式な説明が示すよりも直接的に、開発者をTritonから引き離す狙いがあるのではないか、という指摘です。NVIDIA自身の戦略をどう読むかは、実のところ意見が割れており、決着はついていません。
2026年時点の代替選択肢
CUDA
20年かけて積み重ねたライブラリ・ツール・ドキュメント群。多くのAI研究者が最初に触れる既定のプラットフォームであり、PyTorch・TensorFlowにおいて最もサポートが手厚いバックエンド。
ROCm
2026年時点で、PyTorch・vLLM・SGLangはいずれも公式にROCmに対応。AMDは世代ごとの推論性能の大幅な向上を報告しており、十分にサポートされたワークロードでは実質的な進展が見られる。もっとも、より広範なライブラリエコシステムでは依然としてCUDAに後れを取る。
Triton
チッププラットフォームではなく、可搬性の高いPythonベースのカーネル言語。現在はPyTorch自身のコンパイラの既定のカーネル生成経路となっており、CUDA固有のロックインを最も直接的に侵食している存在だと言える。
oneAPI
CPU・GPU・その他アクセラレータを横断するIntelのクロスアーキテクチャ・ソフトウェア基盤。オープンな代替として位置づけられているが、CUDA・ROCmいずれと比べても導入実績・ライブラリエコシステムの規模は小さい。
06CUDAが重要な理由
CUDA自体は、NVIDIAが販売したり売上高を個別に開示したりしている製品ではありません。利用は無料で、その見返りはすべてNVIDIAのハードウェア販売という形で現れており、市場もそれを織り込んで評価しています。NVIDIA全体の時価総額の推移やデータセンター事業の売上高については、本サイトのGPUの歴史を扱う記事で詳しく紹介しています。CUDAに固有の論点は別のところにあります。競合の半導体メーカーがNVIDIAの地位に追いつくうえで最も難しいのは、個々のチップの生スペックではなく、CUDAが持つエコシステムの厚みそのものです。
関連記事
NVIDIAとGPUの歴史
NVIDIA自体の時価総額の推移やデータセンター事業の売上高を詳しく紹介。
07今後の課題
市場シェアの推計は出典によってばらつく
CUDAの優位性を示す市場シェアの数値は、出典によって大きく食い違い、独立した監査も受けていません。NVIDIAのAIアクセラレータ市場シェアについて、アナリストの推計は手法や集計時期によって約75%から80%台後半までばらついています。手法を完全に透明な形で公表している調査会社も見当たりません。個々の数値はあくまで傾向を示すものとして受け止めるべきでしょう。
AMDのROCmが差を縮めつつある
AMDの「ROCm」プラットフォームは、実際に差を縮めつつあります。2026年時点で、PyTorch・vLLM・SGLangはいずれも公式にROCmへ対応しており、AMDは世代を追うごとに推論性能が大きく向上していると報告しています。つまり、十分にサポートされた特定のワークロードに限れば、CUDAとの実用上の性能差は縮まってきているということです。もっとも、ドキュメントやツールの成熟度、エッジケースのライブラリ対応といった、より広いエコシステム面では、依然としてCUDAに後れを取っています。
Tritonがモートを侵食するかは未確定
Tritonのような可搬性の高いコンパイラが、最終的にCUDAのモートを侵食するのか、それとも取り込まれて終わるのかは、上記「モートに入った亀裂」の節で見た通り、まだ答えの出ていない問いです。
関連記事
NVIDIA「Jetson」
フィジカルAIのブームより10年以上前から続く、エッジAI向けハードウェアの系譜。
08よくある質問(FAQ)
CUDAはチップですか、それともソフトウェアですか?
ソフトウェアです。CUDAは並列コンピューティング基盤で、言語拡張・コンパイラ・ランタイムから成ります。これにより開発者は、NVIDIAのGPUハードウェア上で直接動くコードを書けます。利用は無料で、NVIDIAはその見返りをすべてGPUハードウェアの販売を通じて得ています。
競合他社はなぜCUDAを単純にコピーできないのですか?
個々の要素(コンパイラ・ライブラリ)は、AMDのROCmのような競合によって近い水準まで再現されつつあります。難しいのは、CUDA固有の前提のもとに構築された20年分の本番コードの蓄積です。具体的には、カーネル最適化・デバッグツール・フレームワーク対応などを、実際のコストとリスクを負って別のプラットフォームへ再構築し直す必要があります。
OpenAIの「Triton」はCUDAへの脅威なのですか?
これまでのところ、CUDA固有のロックインを最も直接的に侵食している存在です。Tritonは開発者が可搬性の高いGPUカーネルを書けるようにするもので、現在ではPyTorchのコンパイラの既定のカーネル生成経路になっています。NVIDIA自身によるTritonからTile IRへのバックエンド構築がこの脅威を無力化しているのか、それとも対応が必要なほど深刻な脅威である証拠なのかは、実際に議論が分かれています(詳しくは上記「モートに入った亀裂」の節)。
09出典
03. 現在のエコシステムの規模
05. モートに入った亀裂
関連記事
企業・市場データ
Deep Dive
Tesla
Unitree
Figure AI
1X Technologies
Physical Intelligence
Skild AI
Anduril
NVIDIA
- ›NVIDIA Isaac GR00Tとは:NVIDIAがロボティクスで実際に売っているもの
- ›NVIDIA DRIVEとは:メルセデス・ベンツやUberなど十数社が採用する自動車向けプラットフォーム
- ›NVIDIA Jetsonとは:「フィジカルAI」より10年早く始まっていたハードウェアの系譜
- ›NVIDIAとGPUの歴史
- ›NVIDIA CUDAとは:NVIDIAのAI覇権を支えるソフトウェアの正体(この記事)
- ›ジェンスン・フアン:デニーズの皿洗いからNVIDIA CEOへ