企业与机器人数据库
NVIDIA CUDA 详解:支撑 NVIDIA AI 护城河的软件
要点
- CUDA(2006 年)是软件平台,而非芯片——它让开发者能够编写可直接在 NVIDIA GPU 上运行的通用代码。
- 在 AI 的 GPU 时代到来前,六年的先发优势不断累积,形成了竞争芯片厂商至今仍未能跨越的软件护城河。
- NVIDIA 表示,如今全球有 600 万开发者以 CUDA 为基础,不过 OpenAI 的 Triton 等竞争者正在逐步侵蚀 CUDA 专属的锁定效应。
01CUDA 简介
CPU 与 GPU:少数大核心 对比 数千个小核心
GPU 相对 CPU 的核心优势在于,它拥有数千个小型处理核心,可以对大量数据同时执行同一种运算,而不是依靠少数几个针对快速依次执行不同运算而优化的核心。这种特性天生适合图形处理——屏幕上的每个像素都需要执行相似的数学运算——但在 CUDA 出现之前,要把这种并行能力用于图形以外的任何用途,都必须把计算伪装成图形操作,再通过 OpenGL 处理,是一种笨拙且受限的变通方法。
CPU(中央处理器)
少量大型通用核心,每个核心都针对尽可能快速地依次执行多种不同运算而优化。
GPU(图形处理器)
数千个结构简单的小型核心,都能对不同的数据同时执行同一种运算。
示意比例,并非任何具体芯片的真实核心数量。
CUDA 于 2006 年发布
CUDA 于 2006 年 11 月推出,是一个平台——包括对 C 和 C++(后来扩展到 Python、Fortran 等语言)的一组扩展、一个编译器和一个运行时——让开发者可以编写直接运行在 GPU 并行核心上的代码,这些核心被组织成由数千个并发“线程”构成的网格,而无需假装这是一项图形任务。正是这一项改变,让计算机图形学以外的研究者得以把 GPU 用于物理仿真、蛋白质折叠,并最终用于神经网络。
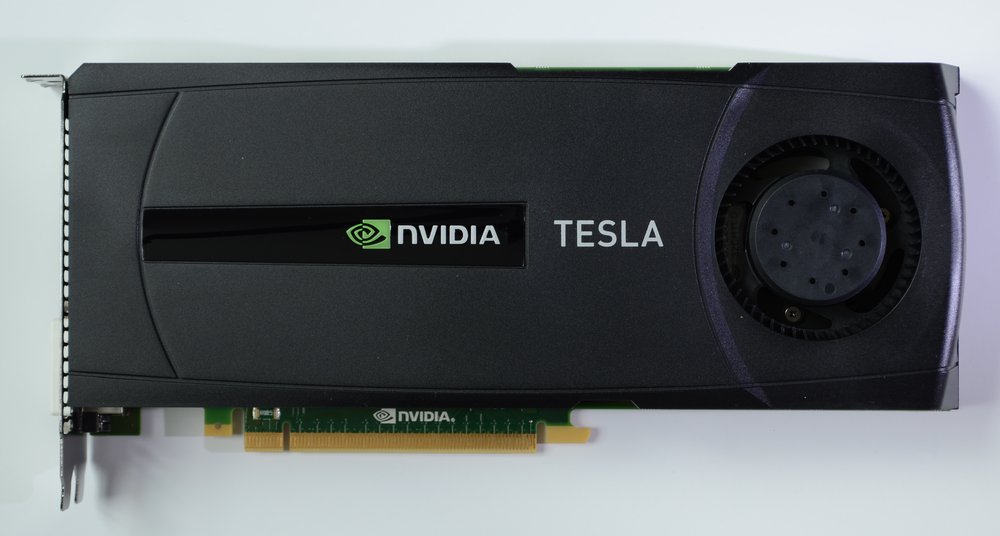
一块 Tesla 品牌的 NVIDIA 计算 GPU——这是 NVIDIA 专为 CUDA 工作负载(科学计算、仿真,后来是深度学习)而非游戏打造的产品线,早在“AI 芯片”成为一个被谈论的品类之前就已存在。
图片:Raysonho,CC0,via Wikimedia Commons02从编译器到库的帝国
CUDA 本身只是底层基础。真正在生产环境中被使用的,是 NVIDIA 在其上历经二十年构建的一整套专用软件库,每一个都针对特定类别的问题做了优化。
CUDA 的软件库体系
- cuBLAS 与 cuFFT——线性代数与信号处理,源自 CUDA 最早期的年代
- cuDNN(2014 年)——卷积、激活函数等深度学习基础运算,后来成为 AI 热潮的底层支撑
- NCCL——协调单次训练任务中数千块 GPU 之间的通信
- TensorRT——优化已训练模型,使推理速度尽可能快
- RAPIDS——把 CUDA 加速计算扩展到过去需要 CPU 集群才能完成的数据科学工作负载
这些软件库中的每一个,都凝结了 NVIDIA 工程师多年针对自家硬件手工调优的成果——这类优化工作,竞争对手必须为自己的芯片从零重做一遍。
| 年份 | 事件 |
|---|---|
| 2006-11 | CUDA 1.0 与 Tesla GPU 架构同步发布 |
| 2007 | cuBLAS 与 cuFFT 发布——首批被广泛使用的 CUDA 数学库 |
| 2012 | 在 CUDA 编程的 GPU 上训练的 AlexNet 赢得 ImageNet 竞赛,重塑机器学习格局 |
| 2014 | cuDNN 发布,提供专为深度学习手工调优的基础运算 |
| 2015 | NCCL 发布,协调单次训练任务中众多 GPU 之间的通信 |
| 2016 | TensorRT 发布,为已训练模型的快速推理进行优化 |
| 2018 | RAPIDS 发布,将 CUDA 加速计算扩展到数据科学工作负载 |
| 2026-01 | NVIDIA 构建 Triton 到 Tile IR 的后端,让 OpenAI 的 Triton 可直接编译为 CUDA Tile IR |
| 2026-04 | NVIDIA 在 GTC 上纪念 CUDA 二十周年,宣称拥有 600 万开发者 |
03如今的生态规模
CUDA 数字概览
NVIDIA 在 2026 年 4 月的 GTC 上庆祝 CUDA 诞生 20 周年,并表示该平台目前支撑着全球 600 万名开发者——这是一个自行披露、未经独立审计的数字,但与 CUDA 作为研究者首选默认平台这一广泛报道的地位相符。
飞轮效应与向后兼容的承诺
CEO 黄仁勋将 CUDA 的经济学描述为一种“飞轮”:二十年来累积部署的兼容 CUDA 的 GPU,构成了吸引开发者和新应用的装机基础,而这些开发者和应用又反过来促使更多人购买兼容 CUDA 的硬件。NVIDIA 还表示,为 2006 年最初一代 GPU 编写的 CUDA 代码,如今仍能不加修改地运行在现役硬件上——这是一项具体的向后兼容性主张,也是基于 CUDA 构建的代码库随着 NVIDIA 硬件迭代而很少需要重写的原因之一。
NVIDIA 官方发布的 CUDA 二十周年回顾(2026 年 4 月),与下文讨论的“600 万开发者”及“CUDA 飞轮”说法一同在 GTC 上公布。
04护城河:为何难以转向其他平台
经年累积的、针对硬件的细节决策
从原理上讲,NVIDIA 的单个库都并非不可复制——竞争对手已经打造出了可比的替代品。真正难以复制的是这种积累本身:构建在 CUDA 之上的生产级 AI 系统,通常沉淀了多年针对特定硬件的细节决策——针对 NVIDIA 特定内存层级调优的内核优化、围绕 NCCL 假设构建的混合精度训练路径、围绕 NVIDIA 自家工具(Nsight)搭建的调试与性能分析工作流,以及默认 CUDA 存在的 CI/CD 流水线。这些都不会出现在芯片规格表上,但若要迁移到另一个平台,就必须以实实在在的工程成本重做这一切。
PyTorch 与 TensorFlow 都以 CUDA 优先构建
两大使用最广泛的深度学习框架 PyTorch 和 TensorFlow,最初也都是以 CUDA 优先的方式构建的。尽管此后二者都陆续加入了对其他后端的支持,但无论选用哪一个框架,CUDA 依然是支持最完善、文档最齐全的路径。
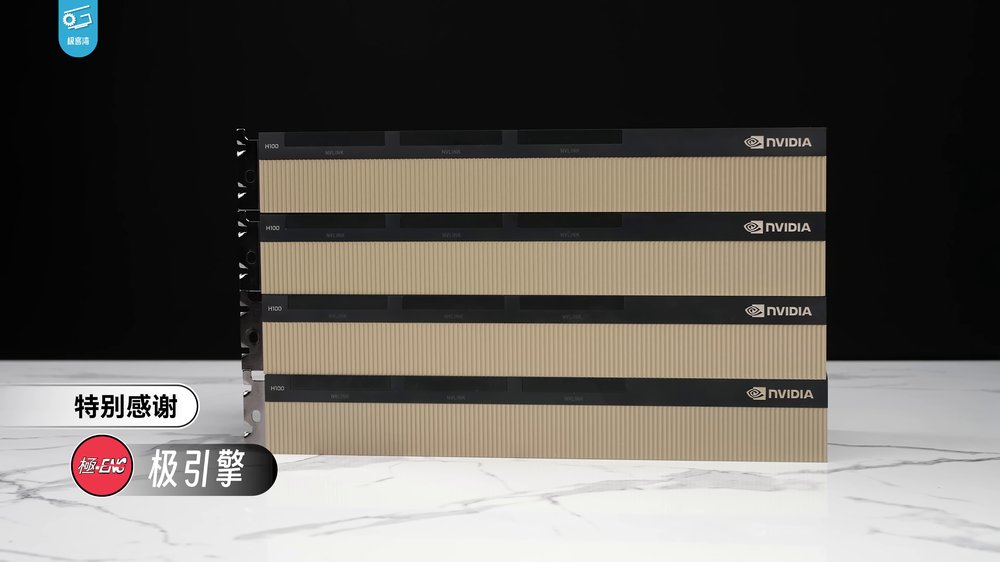
H100(2022 年)——按 NVIDIA 自己的说法,2006 年编写的 CUDA 代码如今仍能在这类现役硬件上运行,只是速度快得多。这一向后兼容性说法将在下文详细讨论。
图片:Geekerwan,CC BY 3.0,via Wikimedia Commons05护城河上的裂缝
Triton:一种可移植的内核语言
对 CUDA 锁定效应最明确的挑战,并非来自某款竞争芯片,而是来自一层竞争性的抽象层。OpenAI 的 Triton 是一种基于 Python 编写 GPU 内核的语言,能让开发者只写一次代码,就在不同硬件上获得接近同等水平的性能,如今它已是 PyTorch 自家编译器(torch.compile)内部默认的内核生成路径——这意味着,越来越大比例的新 PyTorch 代码不再直接接触 CUDA 专属代码。
NVIDIA 的回应,以及一种存在争议的战略解读
NVIDIA 自己的应对方案,在 GTC 2026 上首次预告,是 CUDA Tile IR,以及一个让 Triton 能直接编译到该中间表示的后端——NVIDIA 将其定位为一种合作关系,因为 Triton 自身基于 tile 的编程模型天然可以映射到 Tile IR 上,让开发者无需离开 Triton 就能获得 NVIDIA 专属的性能提升。但一些参与过 CUDA 早期开发的工程师公开提出异议,认为 NVIDIA 相关的 cuTile 语言,实际目的更直接地是把开发者从 Triton 拉走,而非 NVIDIA 公开说法所暗示的那样。这是一个对 NVIDIA 自身战略确实存在争议的解读,并非已有定论。
截至 2026 年的替代方案
CUDA 平台
二十年积累的软件库、工具和文档。是多数 AI 研究者最先接触的默认平台,也是 PyTorch 和 TensorFlow 中支持最完善的后端。
ROCm 平台
截至 2026 年,PyTorch、vLLM 和 SGLang 均已提供官方 ROCm 支持,AMD 也报告了显著的代际推理性能提升——在获得良好支持的工作负载上确有实质进展,但更广泛的软件库生态仍落后于 CUDA。
Triton 编译器
这是一种可移植、基于 Python 的核函数语言,而非芯片平台——如今已是 PyTorch 自身编译器内默认的核函数生成路径,可以说是迄今为止对 CUDA 专属锁定最直接的侵蚀。
oneAPI 平台
Intel 的跨架构软件平台,覆盖 CPU、GPU 及其他加速器——被定位为一种开放的替代方案,但其存量装机基础和软件库生态都小于 CUDA 或 ROCm。
06CUDA 为何重要
CUDA 本身并不是 NVIDIA 出售或单独披露营收的产品——它可以免费使用,其回报完全体现在 NVIDIA 的硬件销售中,而市场也据此对其估值。NVIDIA 整体市值走势与数据中心营收,本站的 GPU 发展史文章已有完整梳理;与 CUDA 具体相关的一点是,竞争芯片厂商最难赶上的部分,并非某一款芯片的纸面参数,而是其生态的深度。
相关阅读
《NVIDIA:GPU 发展史》
NVIDIA 自身市值走势与数据中心营收的完整脉络。
07前方挑战
市场份额估算因来源而异
关于 CUDA 主导地位的市场份额数字因信息来源不同而差异很大,且未经独立审计——不同分析师对 NVIDIA 在 AI 加速器市场份额的估算,因方法和统计周期不同,从约 75% 到接近 90% 不等,且没有一家发布完全透明、可核验的方法论。任何单一数字都应视为方向性参考。
AMD 的 ROCm 正在缩小差距
AMD 的 ROCm 平台确实缩小了差距:截至 2026 年,PyTorch、vLLM 和 SGLang 都已提供官方 ROCm 支持,AMD 也报告了显著的代际推理性能提升——这意味着,在获得良好支持的特定工作负载上,与 CUDA 的实际性能差距已经收窄,尽管在更广泛的生态(文档、工具成熟度、边缘场景库覆盖)方面仍然落后。
Triton 是否会侵蚀护城河,目前仍无定论
Triton这类可移植编译器最终会侵蚀CUDA的护城河,还是被其吸收,眼下仍无定论,原因见上文“护城河的裂缝”一节。
相关阅读
NVIDIA Jetson 边缘计算平台
早在物理 AI 热潮兴起十余年前就已存在的边缘 AI 硬件血统。
08常见问题
CUDA 是芯片还是软件?
是软件。CUDA 是一个并行计算平台——包括语言扩展、编译器和运行时——让开发者能够编写直接运行在 NVIDIA GPU 硬件上的代码。它可以免费使用;NVIDIA 从中获得的回报完全来自 GPU 硬件销售。
竞争对手为什么不能直接复制 CUDA?
编译器、软件库这些单独的组成部分,AMD 的 ROCm 等竞争对手已经做出了近似替代品。真正难以复制的,是二十年间围绕 CUDA 专属假设积累起来的生产代码——核函数优化、调试工具、框架支持——这些都需要重新开发才能迁移到另一个平台,代价和风险都是真实存在的。
OpenAI 的 Triton 会威胁 CUDA 吗?
这是迄今为止对CUDA专属锁定最直接的侵蚀——Triton让开发者能编写可移植的GPU内核,如今已是PyTorch编译器默认的内核生成路径。至于NVIDIA自家的Triton到Tile IR后端究竟是化解了这一威胁,还是在回应一个真实存在的威胁,业内确实存在争议,详见上文“护城河的裂缝”一节。
09参考来源
03. 如今的生态规模
05. 护城河上的裂缝
相关文章
企业深度分析
Tesla(特斯拉)
Unitree
Figure AI
1X Technologies
Physical Intelligence
Skild AI
NVIDIA 公司
- ›NVIDIA Isaac GR00T 详解:NVIDIA 在机器人领域真正卖的是什么
- ›NVIDIA DRIVE 详解:奔驰、Uber 等十余家车企采用的汽车平台
- ›NVIDIA Jetson:支撑物理 AI 的十年硬件谱系
- ›《NVIDIA:GPU 发展史》
- ›NVIDIA CUDA 详解:支撑 NVIDIA AI 护城河的软件(本文)
- ›黄仁勋:从 Denny's 洗碗工到 NVIDIA CEO